

一份不注水的 GEO 检测方案,应该长什么样
上一篇文章(《我审计了一份第三方 GEO 检测报告,教你怎么看数据水分》)发出去之后,被问到最多的问题不是“这家机构是谁”,而是:那到底该怎么测才对?
这个问题值得认真回答。因为 GEO 检测这个行业刚起步、没有标准,报告质量全凭各家良心——你作为要掏钱的企业主或要背书的运营,手里得有一张图纸,才能判断对面递过来的方案是工程还是美术。
这篇就把上次那五处水分逐条反过来:每一处水分背后,都对应一个正确的设计动作。素材全部来自那次审计的一手数据,反面案例在上篇,这篇讲正面。
一、先把”测什么”分开:三类问题,三张报表
上次的报告把所有题目混在一个”综合提及率”里——这是第一处要反的。
GEO 检测的问题其实分三类,测量的东西完全不同:
| 测量对象 | 典型问题 | 该看的指标 |
|---|---|---|
| 新客发现 | “成都有哪些符合预算的学校?“(不带品牌词) | 无提示提及率、有效推荐率 |
| 品牌认知 | “X 学校怎么样?学费多少?” | 事实正确性、信息完整性 |
| 比较与顾虑 | “X 和 Y 有什么区别?退费规则?” | 比较准确性、顾虑回应质量 |
为什么要分开?因为混在一起就可以做手脚:题库里多加几道品牌词问题,提及率立刻上涨——业务没有任何改善,报表变漂亮了。我审计的那份报告,20 道情感题全是品牌词问题(“X 学校怎么样""X 学费贵不贵”),无一例外——测的明明是品牌认知,包装成了整体口碑。
一份诚实的方案,三类问题分三张报表,各自有各自的分子分母。汇总可以,但必须能看到拆开的样子。
二、计数要能重数:每个数字带分子、分母、时间窗
上次审计的第一个发现:8 个平台声称提及 81 条,页面明细重数也是 81 条,总数严丝合缝——但拆开看,DeepSeek 声称 11 条实数 10 条,通义千问声称 10 条实数 11 条。一个多算一个少算,总数凑平,更像两处独立的手工修正,而不是一次采集。
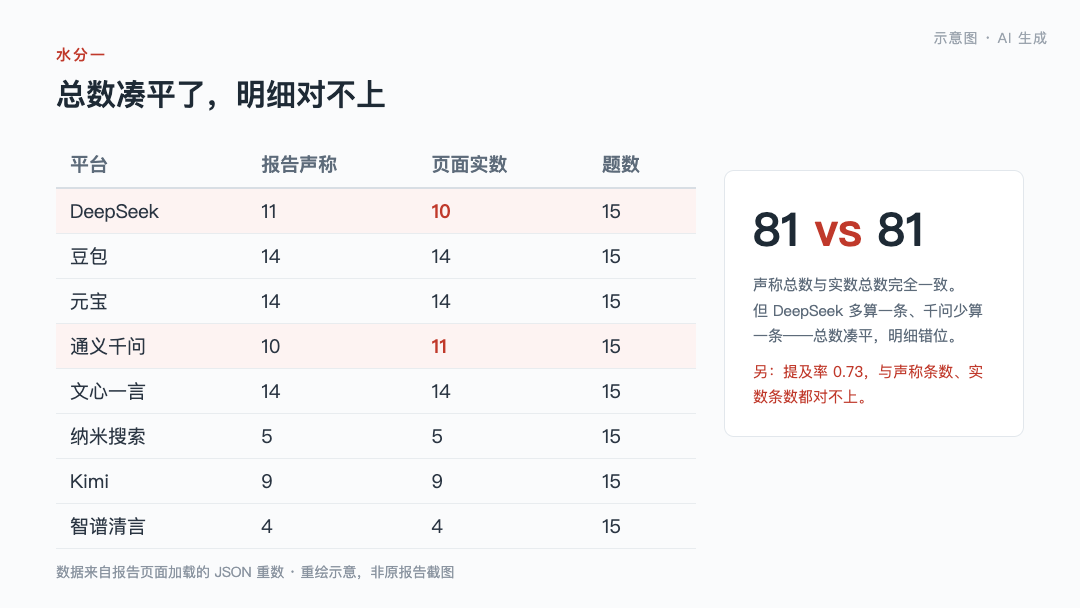
DeepSeek 提及率标 0.73,但 10/15 = 0.67——提及率和提及数对不上,说明这个 rate 是另算的,或者干脆是写死的。
正确的做法其实很朴素:
- 每个指标必须带分子、分母、平台、时间窗四个字段
- 明细可导出(CSV 或原始 JSON),任何人都能重数
- 声称的数字和明细重算的数字必须一致,不一致要有解释
计数一致性是底线。一份报告如果连“数对数”都过不了,后面的分析不用看了。
三、证据要去重:一句话不能当十五条用
上次最刺眼的发现:15 道题,每题的”正面评价”显示 2 到 8 条,但数据包里每道题的独立证据片段(uniqueSnippets)全部等于 1——所有正面结论都出自同一段素材。同一句话,支撑了 15 个不同问题的”好评”。
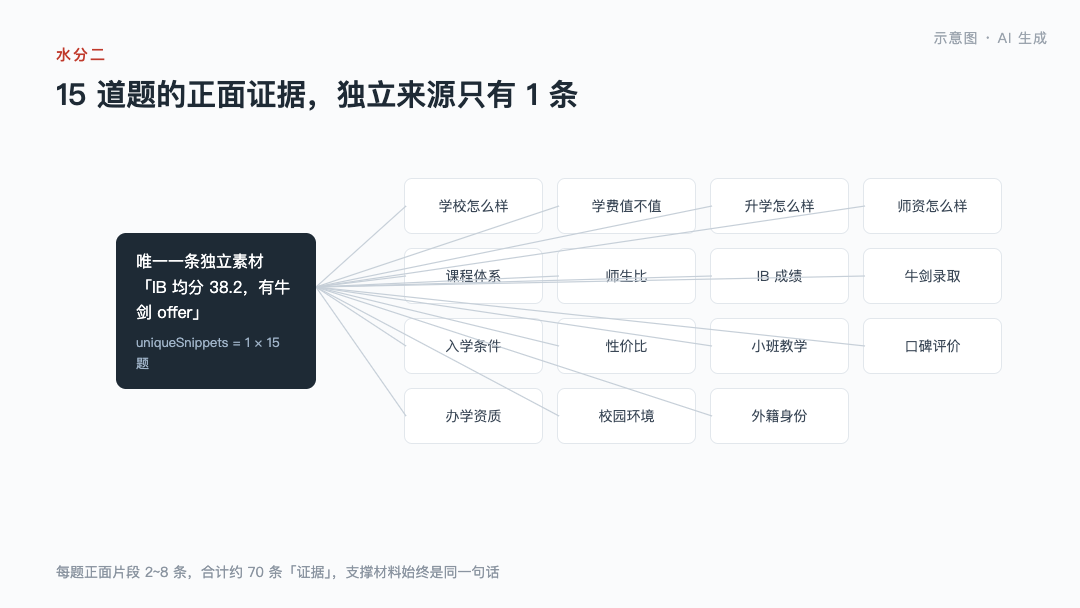
正确的设计要把两层分开:
- 提及层:AI 回答里出现没出现(出现就算)
- 证据层:支撑”正面评价”这个判断的独立素材有几段(要去重)
去重不复杂,证据文本做个哈希就行。关键是报告愿不愿意展示这个数。验收的时候直接问一句:“这道题的正面评价,独立证据有几条?“——uniqueSnippets 大于 1,证据才算数;等于 1,那道题的结论就只是一句话的复读。
四、来源要可回溯:virtual 不是来源
上次的报告里有 12 条”自媒体引用”,其中 4 条的来源字段写着 virtual。virtual 翻译过来就是:这条引用不是检索得来的,是生成的。
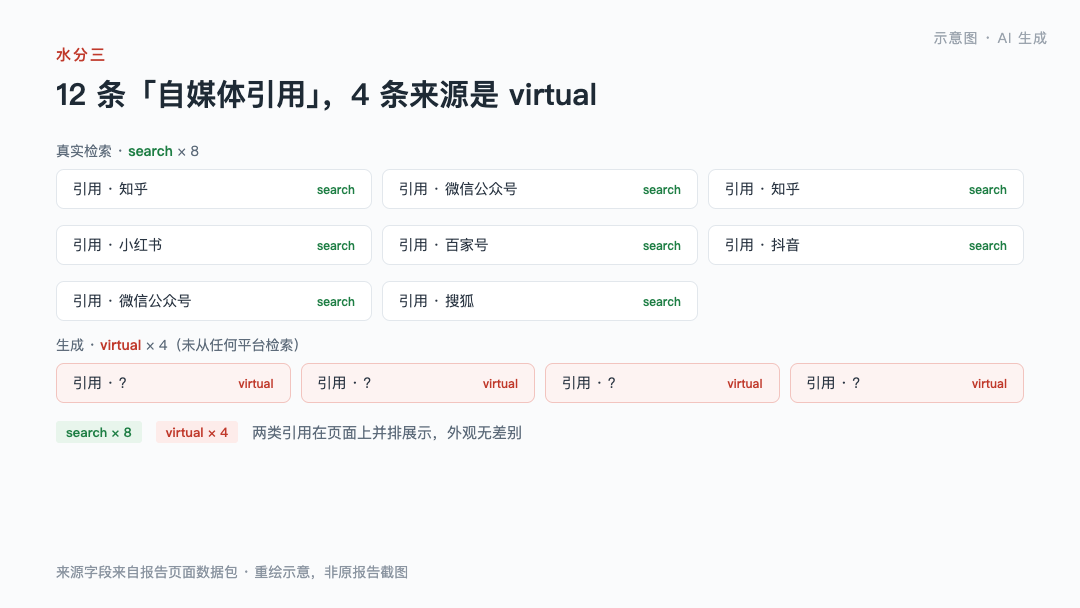
这不是小问题。GEO 检测的核心主张是”你的内容被 AI 引用了”——如果引用本身是检测系统生成的,整个主张就塌了。
正确的设计:
- 每条引用附原文链接和采集时间戳,逐条可点开
- 真实检索结果和模型生成内容分开列出,不能混在一个“引用数”里
- 无法回溯的引用单独计数,标注”不可验证”
验收时随机抽 3 条引用,自己点开看。打不开的、对不上原文的、来源栏是 virtual 的,都可以直接划掉。
五、基准要有分母,预测要有前提
上次报告的综合评分区有三个数:综合 84 分、行业基准 65、超过 78% 的同行。这三个数在后台数据包里就是现成下发的,前端只负责画出来。哪个行业?多少同行?怎么采的样?没有任何说明。
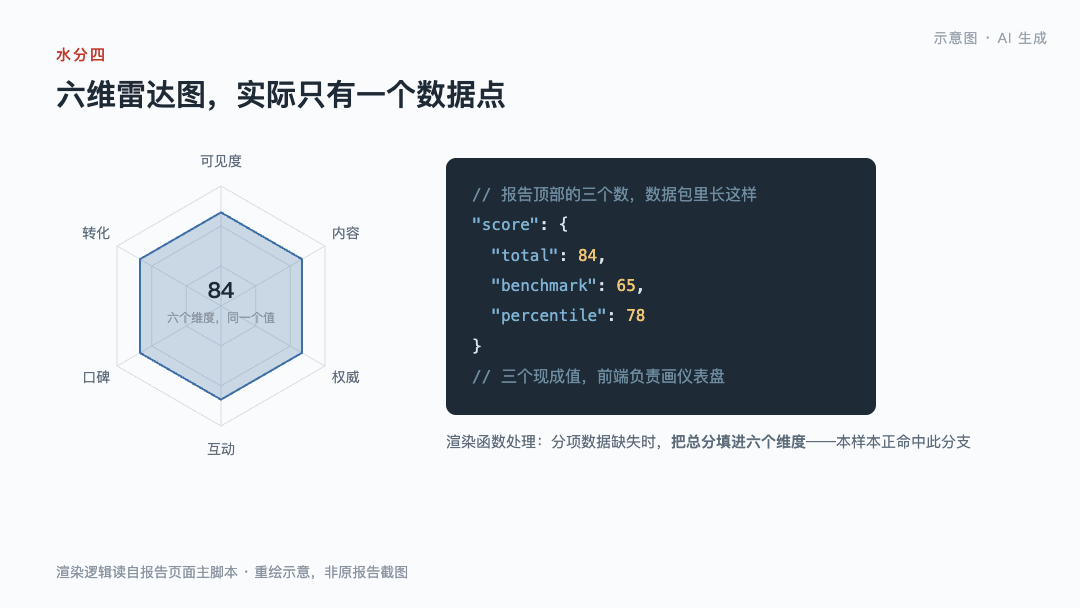
顺带一提那份报告的雷达图:官网的六维雷达在缺少分项数据时,会把总分填进六个维度——六边形看起来饱满,实际只有一个数据点。
优化预测也一样:当前 84 分,优化后 95 分,四个维度的提升整整齐齐都是 +10 左右。依据无处可查。
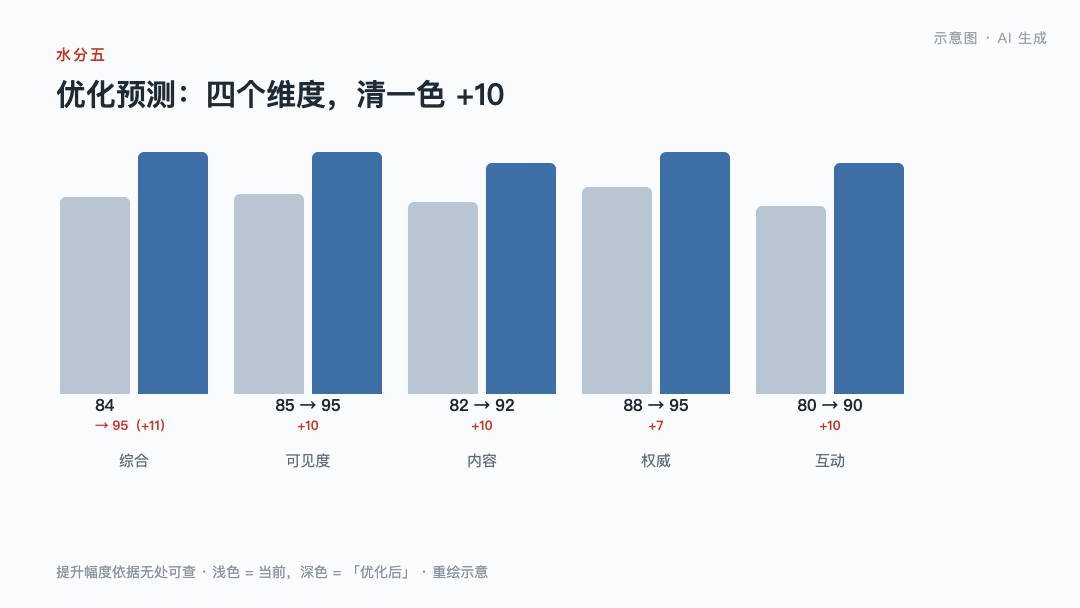
正确的设计分两半:
基准:给出样本构成——行业、样本量、采集方式、更新时间。给不出基准就明说”无基准”,一个没有分母的百分位不如不放。宁可报表空一块,不要硬造一个数。
预测:把”承诺”改成”目标 + 假设”。提升多少、依赖哪些前提(内容产量、发布渠道、时间窗)、多久后用什么方法复测——这三样说清楚,预测才从营销话术变成工程文档。复测的方法就是同题板重跑:同一套题、同一口径、间隔固定时间,对比增量。
六、统计纪律:几个容易被忽略的细节
这部分不反转任何水分,是正面方案里最容易被省略的专业细节。省略它们,报表看起来更干净,但数字是虚的。
分数要带区间。 33/40 = 82.5%,听起来很精确——但这个样本量下,95% Wilson 置信区间是 68.1% 到 91.3%。只报 82.5% 不报区间,是把噪声当信号卖。
别伪精确。 每道题如果只采样 3 次,可能的结果只有 0%、33%、67%、100% 四种。这时候报告里出现”提及率 73.3%“,小数点后那两位是算出来的,不是测出来的。要么提高采样次数,要么诚实报分数档位。
采样过程要留痕。 跨日期复采、每题开新会话、记录当时的模型版本和联网状态、失败与重试全部保留——这些决定了结果能不能复现。还要区分两种”可复现”:历史数字能由留存的原文重新算出(这个可以承诺),和重新提问得到同样答案(AI 的随机性决定了这个只能报分布)。一份靠谱的报告会明确告诉你它承诺的是哪一种。
七、升级版验收清单
把上面所有内容压缩成一张可以带走的表。拿着它去验收任何 GEO 检测方案,一条条过:
| # | 验收动作 | 红线 |
|---|---|---|
| 1 | 要求看题库构成:品牌词题和无提示题各占多少 | 混在一个提及率里的,分数无意义 |
| 2 | 每个指标要分子/分母/平台/时间窗 | 给不出的指标直接划掉 |
| 3 | 导出明细,自己重数一遍 | 声称数和重数不一致的,整份存疑 |
| 4 | 问每题的独立证据数(uniqueSnippets) | 等于 1 的”正面评价”只是复读 |
| 5 | 抽 3 条引用点开看原文 | 来源为 virtual 或打不开的,不算引用 |
| 6 | 基准和百分位要样本构成 | 没有分母的基准是画出来的 |
| 7 | 优化预测要假设和复测方法 | 只有单点数字的预测是话术 |
七条全过,这份报告值得细看;过一半,你至少知道水分藏在哪;一条都过不了,按开头那张图纸的标准——它属于美术,不属于工程。
总结
上篇说过,那份报告不是全盘造假——8 个平台 81 条提及是真的采了,水分藏在证据复用、虚拟来源、直给的基准这些更细的地方。这篇把每一处反向展开,其实就三句话:
口径要拆开,数字要能重算,来源要能回溯。
检测值钱的是增量,不是那个综合分数——同一套题板、同一套口径、隔着时间看变化。这也呼应上上篇《个人网站 GEO 实践》结尾的话:技术是杠杆,内容是本金。这一篇补第三样:测量是仪表盘。杠杆、本金、仪表盘,齐了,GEO 这件事才能当成一门生意长期做下去。
这套口径我自己在用一套实现跑,等数据攒够了,下篇拆开讲。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!