

音乐
暂未播放
一分钱没花,我跑通了一条 AI 短视频流水线
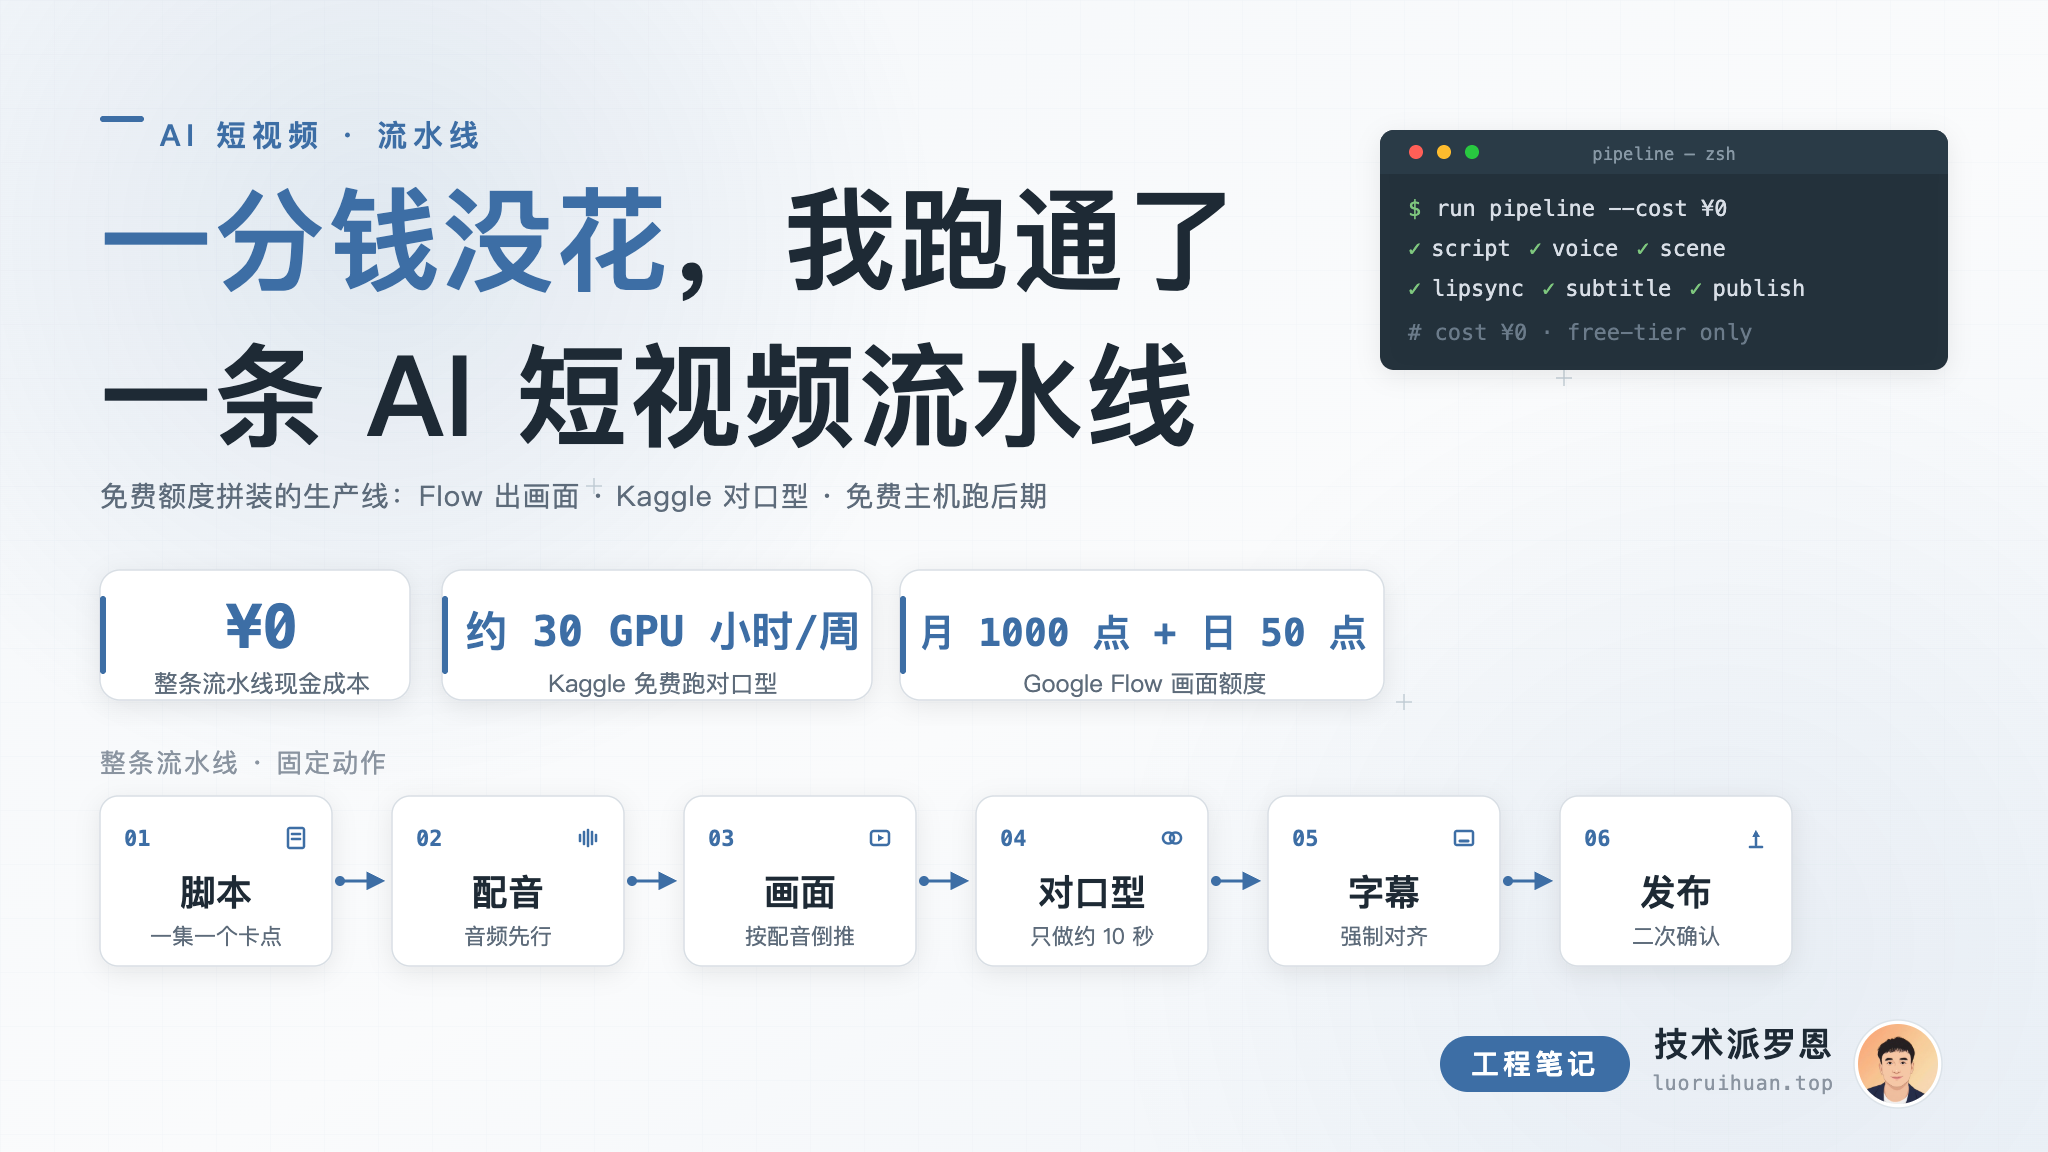
现在AI视频很火,但是做成一个合适的视频相当费钱,那么作为一个技术人,能不能凭借现在大厂提供的免费资源,做一个自己短视频流水线AI视频自动生成呢,答案肯定是可以的,现在我自己的一些第三方相关账号的运营,视频生成都是已经交给我的这套流水线了,实现效果还是不错的,这篇把整条线拆开:每个环节用什么免费资源、额度多少、为什么这样分工,最后是几条事故换来的教训全部分享出来,希望可以帮助到大家。
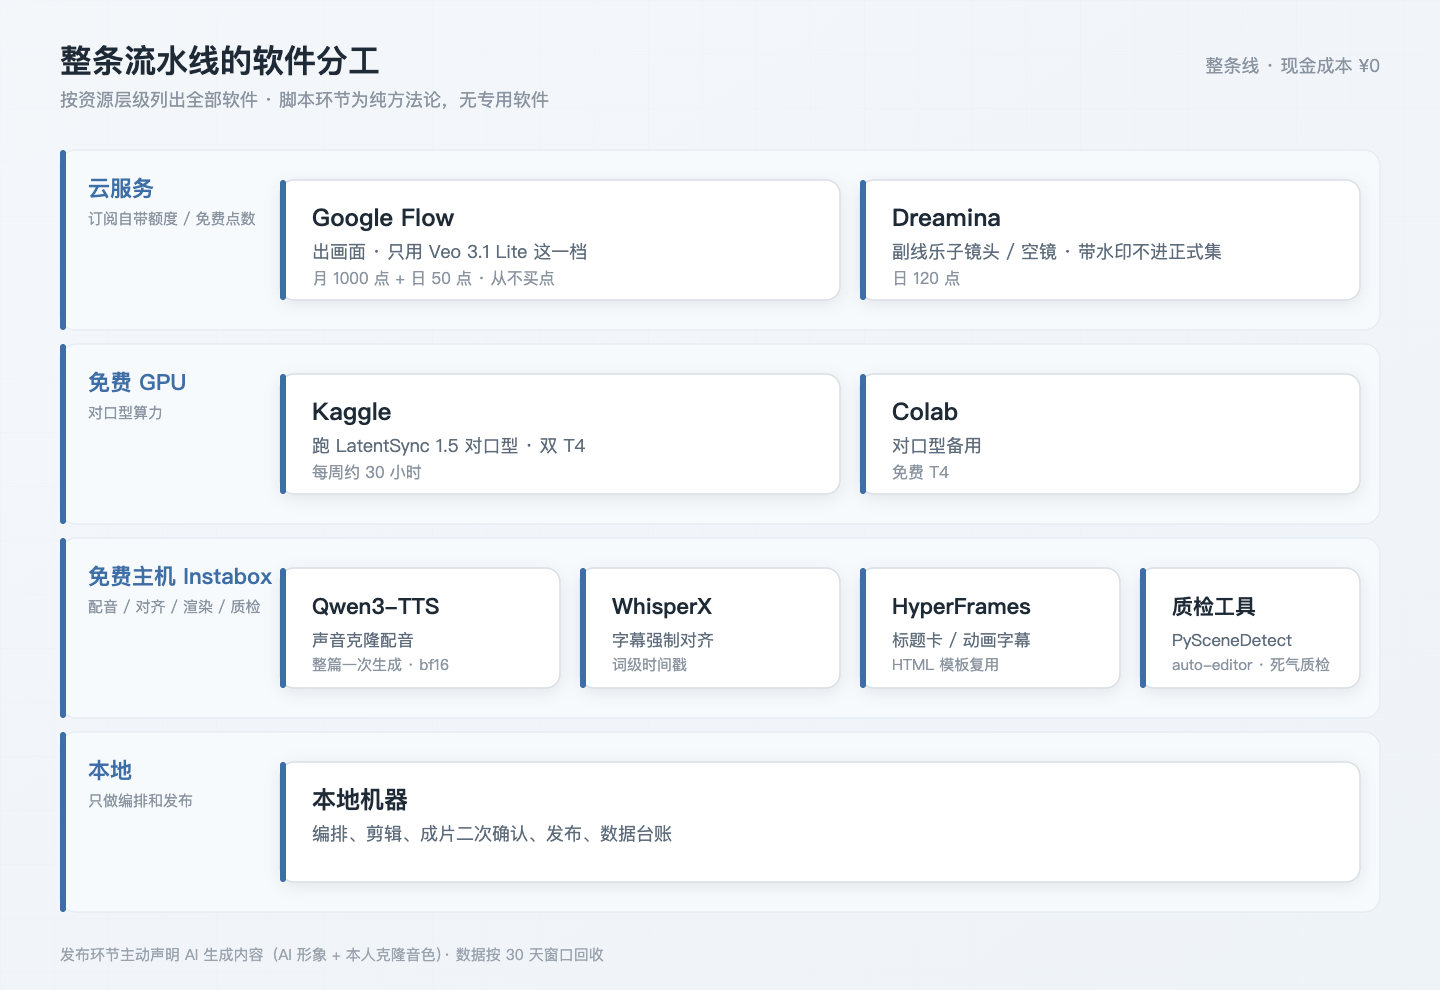
整条线的软件分工
流程一共八步:定稿 → 克隆配音先行锁定 → 按配音时长拍 AI 画面 → 只给片头结尾做对口型 → 字幕从最终音频对齐生成 → 合成质检 → 确认发布 → 数据回收。
各环节的资源分工如下:
| 资源 | 额度 | 干什么 |
|---|---|---|
| Google Flow | 月 1000 点 + 日 50 点 | 正式集画面,只用 Veo 3.1 Lite,不买点 |
| Kaggle | 约 30 GPU 小时/周 | 对口型 |
| Colab | 免费 T4 | 对口型备用 |
| 免费云主机(Instabox) | 免费档 | 配音、对齐、质检、模板渲染 |
| Dreamina | 日 120 点 | 副线乐子镜头和空镜,带水印不进正式集 |
画面是额度消耗的大头,交给 Flow——点数是 Google AI Pro 订阅自带的,只用 Veo 3.1 Lite 这一档,从没买过点。算力要求最高的是对口型,这部分给 Kaggle 的免费 GPU,Colab 的免费 T4 做备用。配音、对齐、质检、模板渲染这些批量活,全压在 Instabox 免费档的云主机上,本地机器只负责编排和发布。
零现金成本的意思是:不为这条流水线额外花一分钱。订阅自带的点数够用,模型全是开源的;GPU 和主机都用免费档。
三笔预算各有取舍。算力上,对口型是全流程算力要求最高的环节,砍到只剩片头结尾约 10 秒,每周约 30 小时的免费配额才覆盖得住。额度上,画面是消耗大头,只用 Veo 3.1 Lite 这一档、只用订阅自带的月 1000 点 + 日 50 点,从不买点。时间上,配音整篇一次生成并锁定,全线拿这份音频当时间基准,返工成本最低;语速不满意在剪辑里微调,不重新生成。
软件到环节、职责的映射:
脚本:唯一的纯方法论环节
脚本没有专用软件,但它决定后面每个软件的用量,是全流程的硬关卡。
每集只讲一个卡点,不做服务清单式罗列。框架是拼装的:定位层用 StoryBrand,客户是主角、我是向导;短版骨架用 PAS/BAB;长版用 PASTOR;再用 Hormozi 的留存审计,逐个 10–15 秒单元自检。悬念配额写死:50 秒短版 = 1 个主悬念 + 0–2 个小悬念,钩子不超过 12 个词,第一句就是痛点结论。篇幅对应:短版约 270 字,长版 900–1100 字。
纪律只有一条:脚本没过审,后面一步都不动——不配音、不拍画面、不烧一点生成额度;脚本批准不等于发布批准。红线:不编造案例和数据,算账一律用「如果……」的测算口径。定稿后顺带产出两篇配套图文,一个卡点喂三个内容。
换题材时才多做一步对标拆解:把对标视频拆成分镜表,镜号、时间码、时长、景别、运镜、台词、转场一格一格填,只学钩子类型、结构、节奏,原台词、原音、原画面不进成片;拆解结果沉淀成镜头语法和钩子结构两类模板。
配音:Qwen3-TTS,跑在一台免费主机上
配音用自己的声音克隆,Qwen3-TTS 开源模型,拿本人朗读录音做克隆参考。
必须整篇一次生成,绝不逐段合成。起因是一次实测翻车:同一篇稿子分段生成,音高分布查出来两个簇,听着像两个人在念。所以现在生成完必做两道校验,语音识别回转校字、查音高分布,无误才锁定。语速不满意在剪辑里微调,不重新生成。
配音跑在 Instabox 那台免费云主机上,精度必须用 bf16。fp32 跑同一篇稿子,内存峰值约 5G,直接被 OOM 杀掉;换 bf16,114 秒生成完。同一篇稿子在本机 CPU 上跑要 1119 秒。免费主机不但跑得通,还快了近 10 倍。
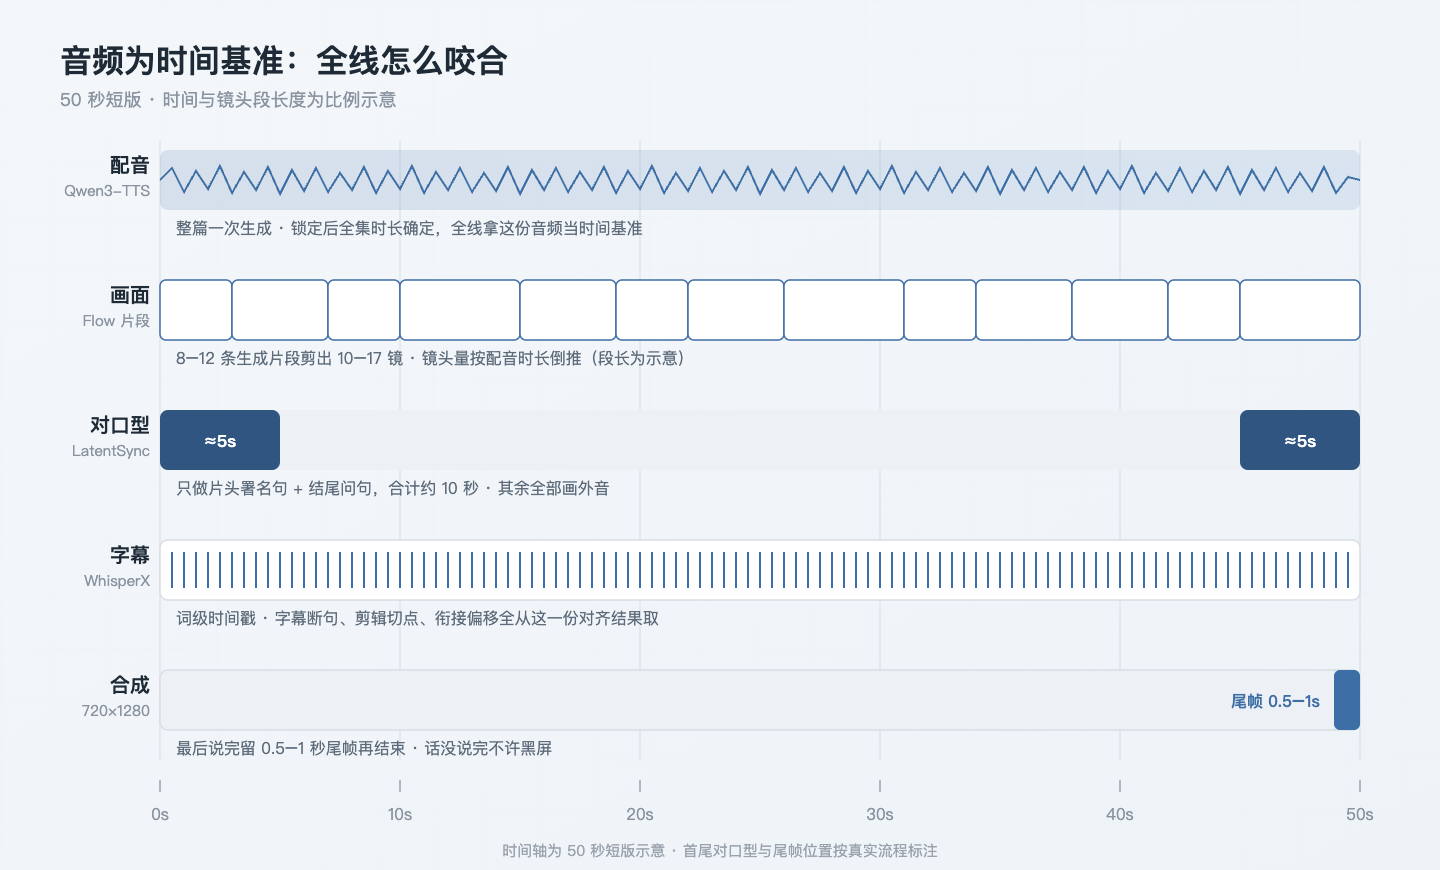
配音一锁定,全集时长就定了,后面所有环节都拿这份音频当时间基准。
画面:Google Flow,只用 Veo 3.1 Lite
画面用 Google Flow 里的 Veo 3.1 Lite,本人正面照片做人物锚点,静音生成。
提示词按官方公式组织:[运镜] + [主体] + [动作] + [场景] + [风格]。两条硬规则:每条片段只给一个运镜,必须带速度词,比如 slow dolly push-in 这种具名运镜,不用 cinematic 这类空形容词;镜头本来就该静止的,要明写「镜头完全静止」,不然模型会自己加戏。
出镜人物——含配角和群众——必须是亚洲中国人的面孔,提示词里显式写明,生成后逐条质检。
镜头量从配音时长倒推:50 秒的成片大约 10–17 个镜头,由 8–12 条生成片段剪出来;平均每个镜头 3–5 秒,画面每 2–4 秒要有一次变化。人物少正对镜头说话,多拍做事、走动、看屏幕的镜头,正脸只留给片头和结尾;结尾的正脸段用半身景别带环境,不贴脸特写。画面里不许出现可读文字、logo、水印,出现即重拍。
长版不纯靠 AI 生成:AI 片段只管钩子、转折、高光;实施段用真实录屏;算账段用定版图表动画——浅蓝转暖米的底色、深石板蓝的字、橙色的数字,这套配色每集固定。
对口型:LatentSync 1.5,吃 Kaggle 的免费 GPU
工具是 LatentSync 1.5,跑在 Kaggle 的免费 GPU 上,双 T4,每周约 30 小时配额,Colab 免费 T4 做备用。
一开始的设想是全片正脸对口型,实测效果只到「中规中矩」四个字。于是砍需求:只保留片头和结尾两段正脸短句,片头是固定署名句,结尾是固定问句,合计约 10 秒;正文全部走画外音,配做事镜头、录屏、图表。正脸段如果还是不过关,宁可整段改成画外音版,也不硬发。
对口型是全流程算力要求最高的环节,砍到只剩 10 秒之后,每周约 30 小时的免费配额覆盖得住这点用量。
字幕与合成:WhisperX 对齐,HyperFrames 出模板
字幕不做盲转写。稿子本来就是已知的,用 WhisperX 把定稿强制对齐到最终配音,一次拿到词级时间戳;字幕断句、剪辑切点、声音衔接偏移,全部从这一份对齐结果里取。实测一篇 285 字的稿子全对齐,字幕逐字对账精确匹配。
转场有白名单:约 90% 用硬切,落在句界或动作点上;J/L 声音衔接偏移 0.2–1 秒;淡化只用来表时间流逝,整条不超过 1–2 次;星形、翻页、故障特效这类转场包一律禁用。要强调某个词,用 punch-in 放大来替代花哨转场。
标题卡和动画字幕走 HTML 模板渲染,工具是 HyperFrames,做成模板复用,不逐集手拼。质检有两件工具:PySceneDetect 逐条检查生成片段的切点,auto-editor 负责把成片里的死气段落剪掉。
合成规格:720×1280 竖屏,烧录字幕,思源黑体粗体、白字深色描边。最后一个字说完之后,留 0.5–1 秒尾帧再结束;配音尾音如果被截断,先做淡出垫静音,不许话没说完就黑屏。
封面不用人物,每集单独设计主题图形封面,不标第几集。
所有环节对齐到同一份音频的咬合关系:
发布与数据回收
成片经本人二次确认才发。发布时主动声明 AI 生成内容:AI 形象,加本人克隆音色。
数据记台账:播放、主页访问、私信咨询,每条标注来源选题。长版按 30 天窗口看数据,不因为 7 天数据差就下结论。节奏上,视频约每周 1 条,每月约 4 条;图文每周约 2 篇穿插发布。
现在的状态和欠账
这条流水线现在单集跑得顺,没为它花过一分钱,每集只换案例、其余固定动作复用。
这条流水线对我来说是 AI 应用工程的一次完整练手:音视频处理、模型选型、额度调度、自动化系统,每一层都还有得抠。如果你也在搭音视频流水线或自动化系统,欢迎来找我聊聊,这条线还能怎么抠,我是技术派罗恩Ron,AI新时代,对于技术充满着无限可能~
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!