

音乐
暂未播放
我做了一个 GEO 工作台,然后发现软件是最不重要的那部分
一份 GEO 报告通常长这样:某个品牌在六个 AI 平台上被提及多少次、被推荐几次、排在第几、哪些竞品被提到了而你没有。
信息很全,看完还是不知道下一步该干什么。
这就是我做完 GeoLens 之后最大的感受。它能告诉你 AI 现在怎么看你,不能替你让 AI 推荐你。真正决定结果的是信源、曝光和一手证据,软件只是把这些照出来。
我为什么做这个东西
【不得不说现在GEO确实很火,很多平台也好,商家也好,借着这个AI得浪潮,希望抢占这个风口,AI是未来,这个毫无疑问,但是AI怎么看你,确实也戳中了很多企业和客户的痛点,大家都很焦虑,所以我就想自己从头走一遍,把现在市场上的GEO掰开揉碎自己做一个看看,到底是真实存在的需求场景,还是换汤不换药有一个广告推广催生的伪命题。说白了,GEO第一步,是一个很具体的问题:我写的东西,到底有没有被 AI 看见。】
手工验证太贵。六个平台——豆包、腾讯元宝、通义千问、DeepSeek、Kimi、文心一言——同一批问题要在每个平台上问一遍,还得把回答原样存下来,隔一段时间再问一遍做对比。问一次不难,难的是每周都问、每次都存、还能对上账。
于是就有了这个工具。它做的事很朴素:把“问一遍”变成“每周问一遍,存档,比对”。
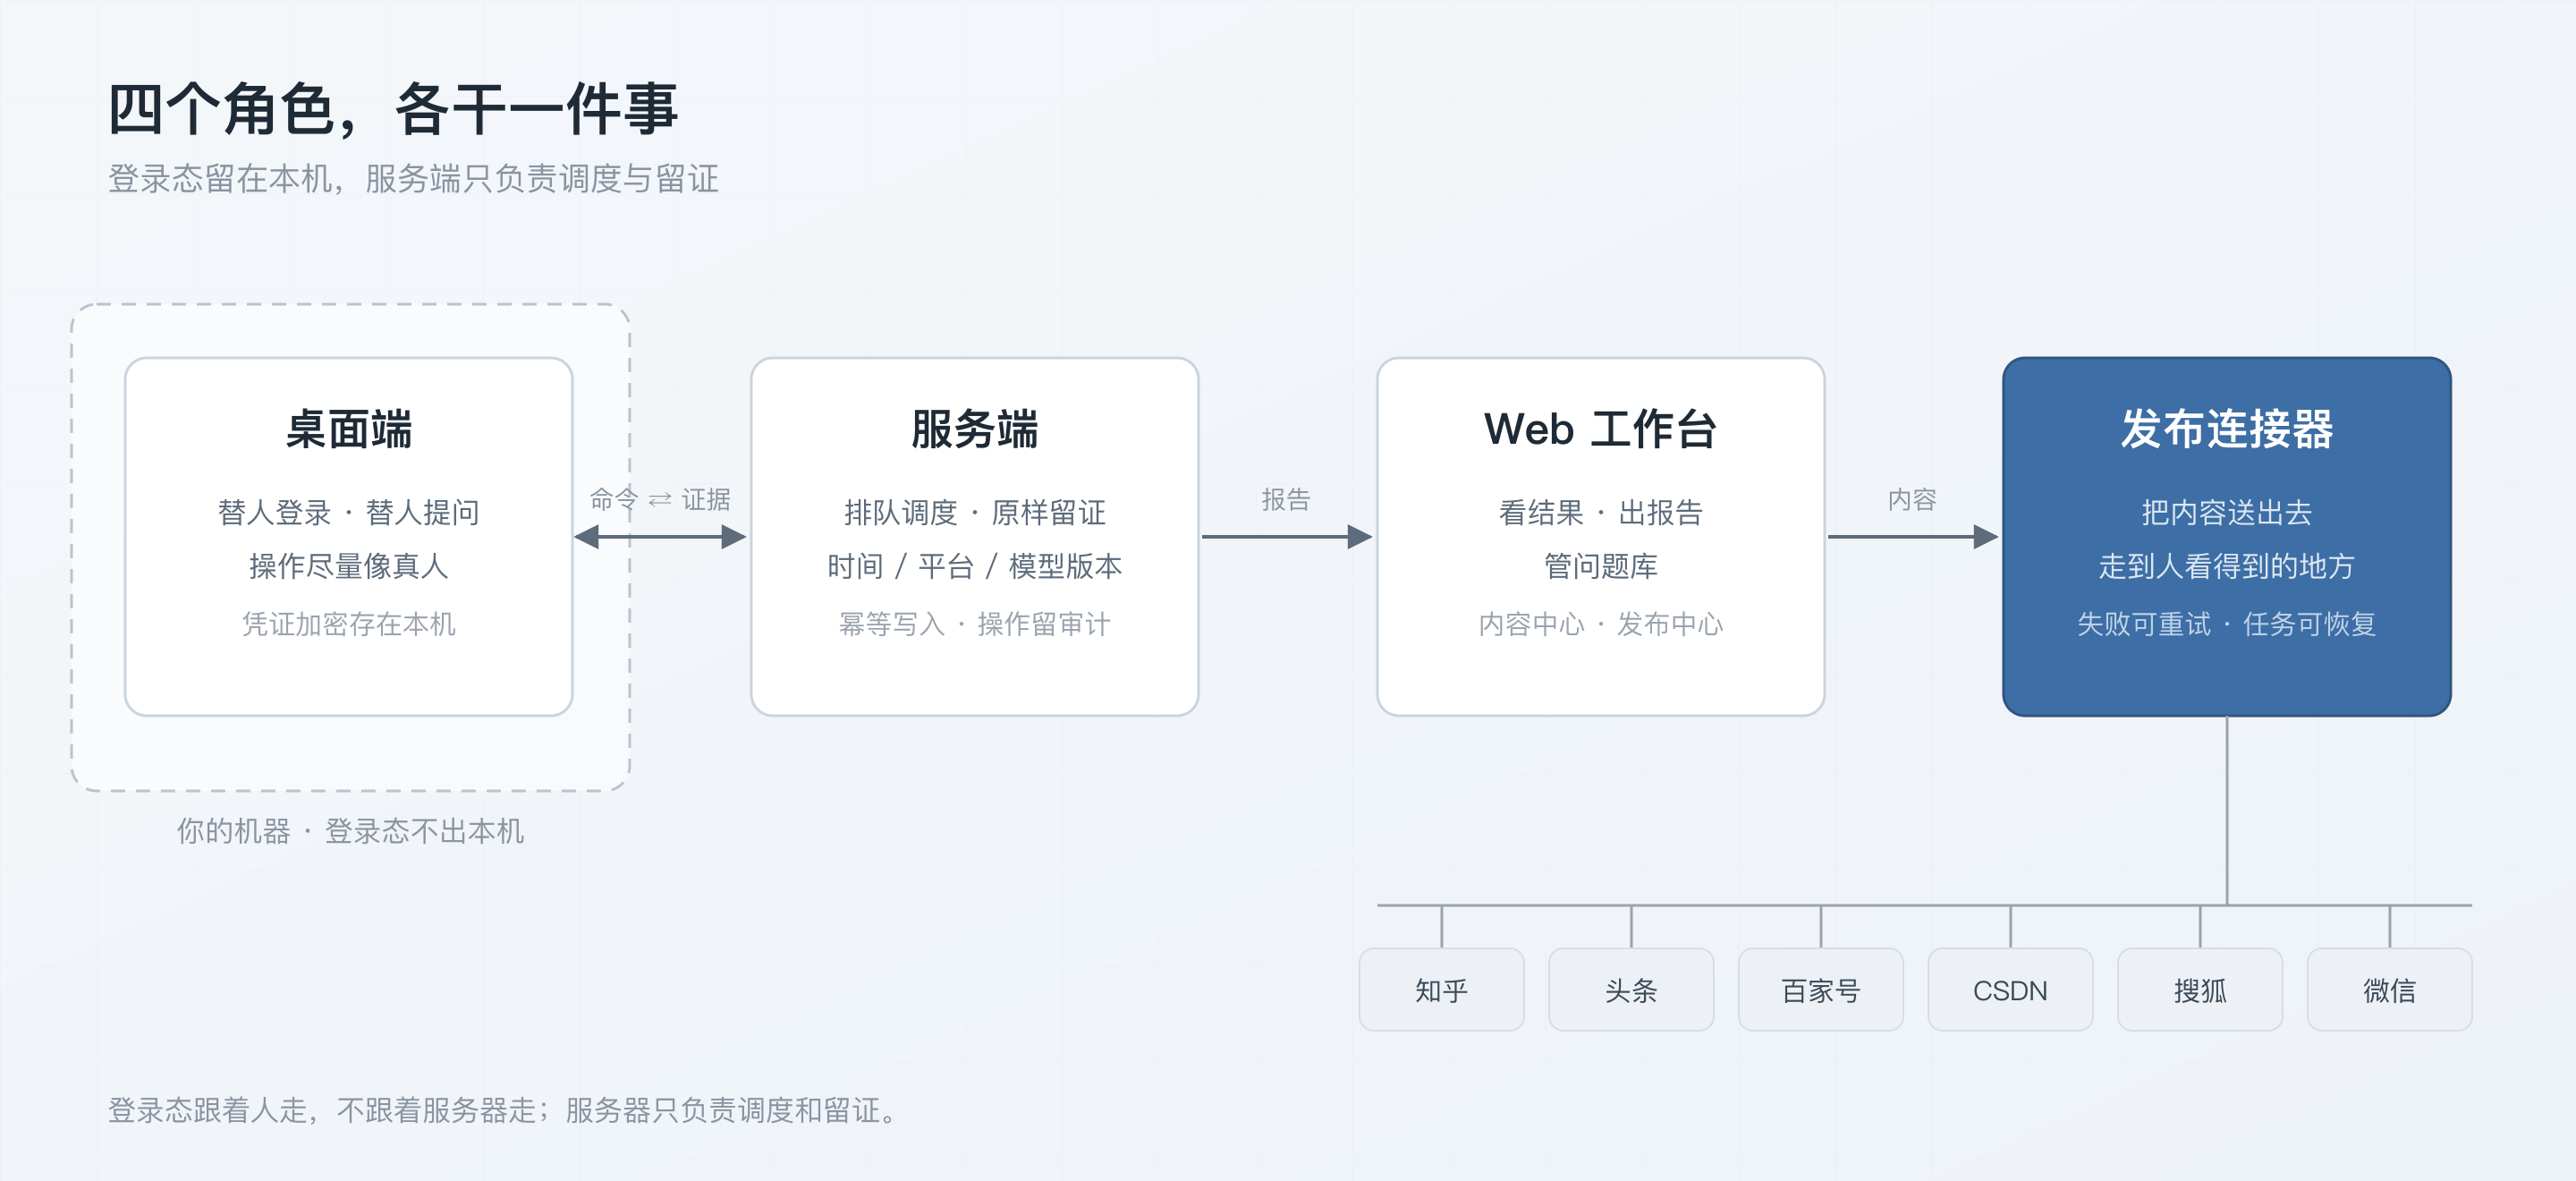
架构:四个角色,各干一件事
我不打算讲技术栈,只讲清楚一件事:为什么它不能做成一个网站。
桌面端,替人登录、替人提问。 这是整个产品最不“互联网”的部分。AI 平台的账号和登录态必须留在用户自己的机器上,不能集中到服务器。同理,提问要和真人在浏览器里的操作尽量一致,否则拿到的回答不代表普通用户看到的那个回答。
服务端,记账和排队。 什么时候问哪个问题、这次回答是什么时候采的、在哪个平台、用的什么模型、有没有联网——这些都要写清楚。它还负责把每次回答原样留下来,出问题时能回到底稿。
Web 工作台,看结果、出报告、管问题库。 也就是本文开头那份报告生成的地方。
发布连接器,把内容送出去。 报告发现问题之后总得做点什么,所以它也能把内容发到知乎、头条、百家号这些平台。这条链路是我后来才加的,加上之后整个产品的重心也变了。
四个角色为什么不能合成一个网站,一句话:登录态跟着人走,不跟着服务器走。 采集要像真人,服务器只负责调度和留证。
三个取舍
第一,不做全自动。 登录、验证码、风控,该人工介入的地方就留给人。
放弃的是一键跑完全程的演示效果——那种演示很好看,一按按钮,六个平台的回答刷刷出来。换来的是能长期跑下去。做监测最怕的不是慢,是跑到第三周账号被封,前面所有数据都成了孤岛。
第二,不补缺失的采样。 没采到的就标没采到,不插值,不猜。
报告因此经常不好看:某个平台那天登录失效,那一格就是空的。但数字要能拿去和别人对账。一份看起来完整、其实是估出来的报告,比一份有空洞的报告更危险。
第三,不把多个指标压成一个分。 提及、推荐、引用、事实是否正确,分开列。
放弃的是一个“GEO 得分 72”那种好传播的数字。换来的是知道问题出在哪一环:是根本没被提到,是提到了但不推荐,还是推荐了但把产品参数说错了。这三种情况的解法完全不同。
还有一个成本向的取舍:采样频率换稳定。不高频轮询,固定时间窗跑一轮。实时感没有了,换来的是趋势可比、额度可控。GEO 的变化以周和月为单位,盯到分钟没有意义。
成本:一个人做,钱花在哪
开发时间是最大的一块,我自己是订阅了 GPT 的 plus,和 deepseek 的 coding plan,加上偶尔白嫖一下智谱的活动,而且大部分花在返工上。做到中途我做了一次完整的代码梳理和对标,把历史包袱盘了一遍,才定下重构路线。这部分时间不会体现在任何演示里,但它决定了后面能不能改得动。
服务器和存储相对便宜:一台常驻机器、一个数据库、一堆报告文件。这类产品不是流量型业务,成本不会随用户数线性暴涨。
平台额度和模型调用要看采样频率。这一点和我做视频流水线是同一个思路:能用订阅自带额度覆盖的,就不额外买。
人工复核最容易被忽略。每周要有人把结果看一遍,判断哪些是平台波动、哪些是真的变化、下周改什么。这部分不写进账单,但少了它,前面几项都会变成摆设。
软件是次要的
先承认必要性:没有测量,你连自己在哪都不知道。但工具能做的事有明确的边界。
它不能让 AI 引用你。 平台不开放写入,你影响不了它说什么,只能影响它读什么。
它不能替你补信源。 报告告诉你“这个问题里你完全没出现”,接下来要做的是去写、去发、去被别人引用。工具在这里帮不上忙。
它不能保证口径稳定。 平台改版、模型换版本、登录态变化,同一个问题两次答案可能不一样。所以我坚持留原始回答和采集条件——不是为了好看,是为了别人质疑时能拿出来。
那什么才真正决定结果?三件事。
信源:AI 读得到的地方有没有你。 这跟 SEO 时代的老办法有一部分是重合的,但坑不一样。比如多数 AI 爬虫不执行 JavaScript,正文如果全靠前端渲染,抓到的就是空页面;robots.txt 的规则组不会继承通配符,你给 User-agent: * 放行了,不等于放行了那批专门的爬虫。这些我在自己站的 GEO 实践里踩过,都是配置层面的事,做完就没有第二次。
曝光:同一类问题下被反复提到,而不是偶尔出现一次。 这个没有捷径,靠持续写、持续发、持续被人引用。工具只能告诉你哪类问题还空着。
一手证据:可验证的项目、数据、可复现的记录。 Google 在 AI 功能优化指南里说得很直白:独特的一手经验比二手总结更容易被引用。原因不复杂——“7 个技巧”这类内容在训练数据里已经泛滥,而“我这样做,结果是 X”是稀缺的。
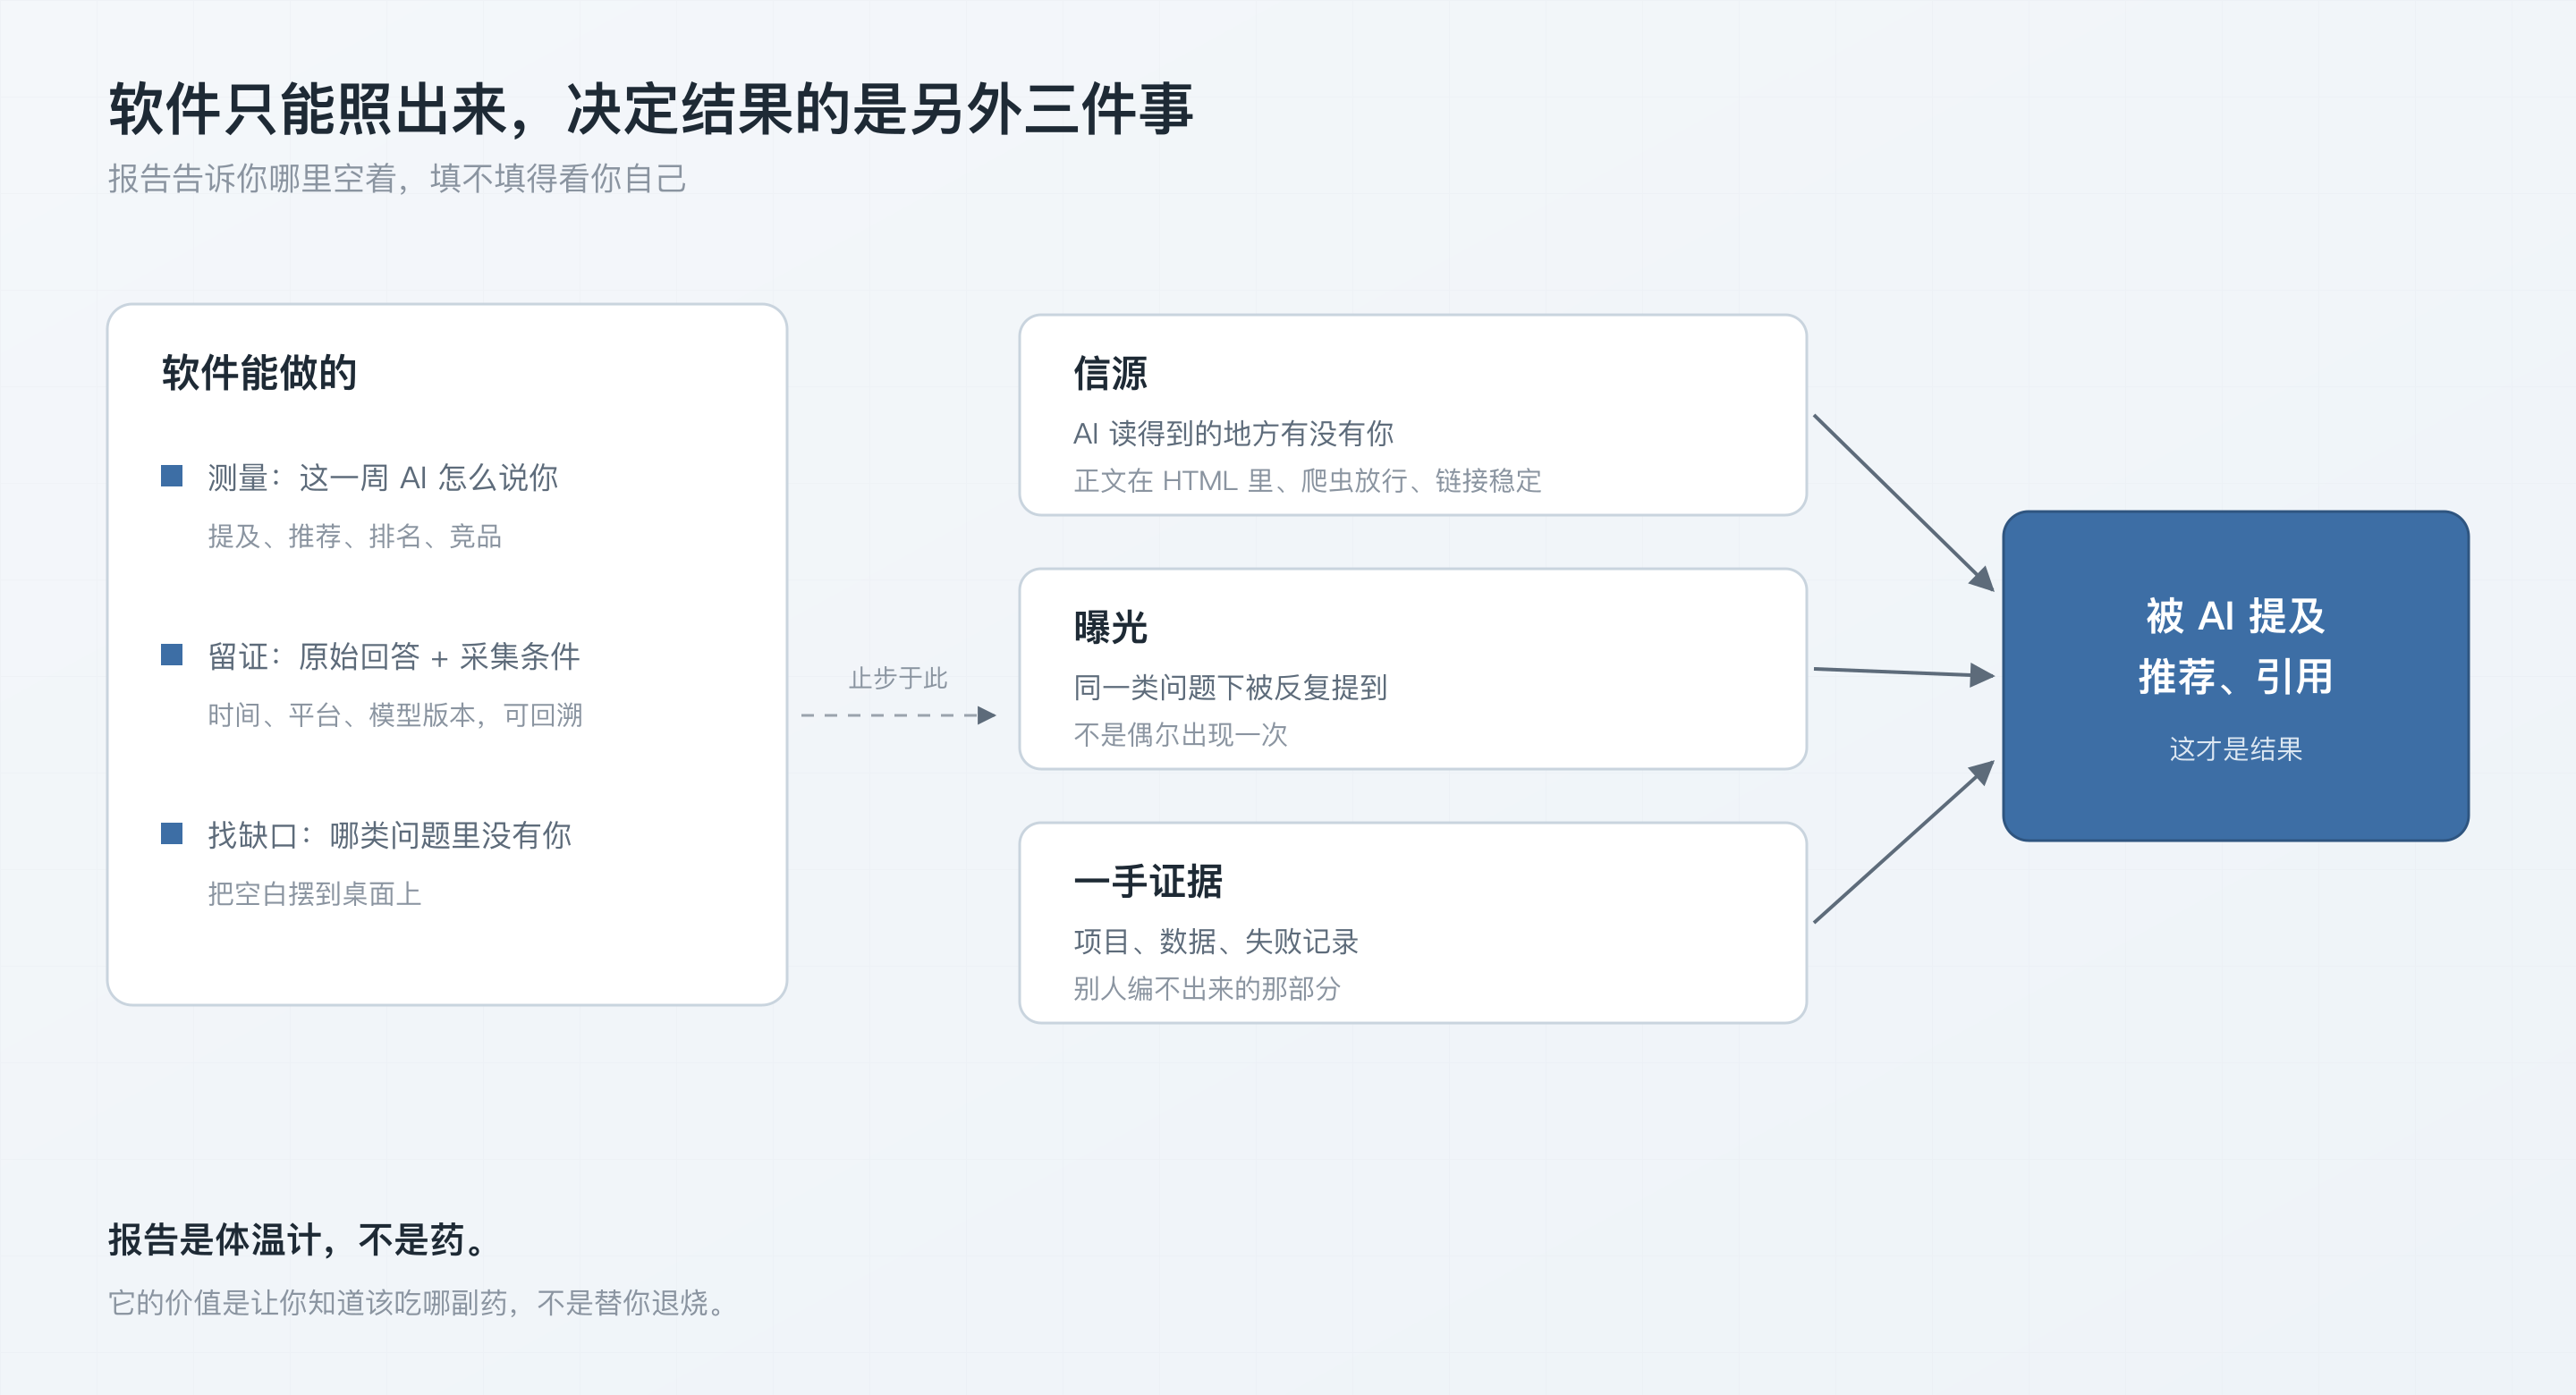
所以我的结论是:报告是体温计,不是药。 它的价值是让你知道该吃哪副药,不是替你退烧。
如果你要用这类工具,我建议这么用
四步,不需要什么门槛:
一、固定一批问题。品牌词、非品牌词、以及你最怕被问到的风险问题,分开列。
二、按周或按月跑一轮,原始回答全部留下来,连同采集时间、平台、模型版本。
三、找缺口。哪些问题完全没提到你,哪些竞品被反复推荐,哪些回答里把你的事实说错了。
四、补信源,四周后用同一批问题复测,看方向,不比单点。
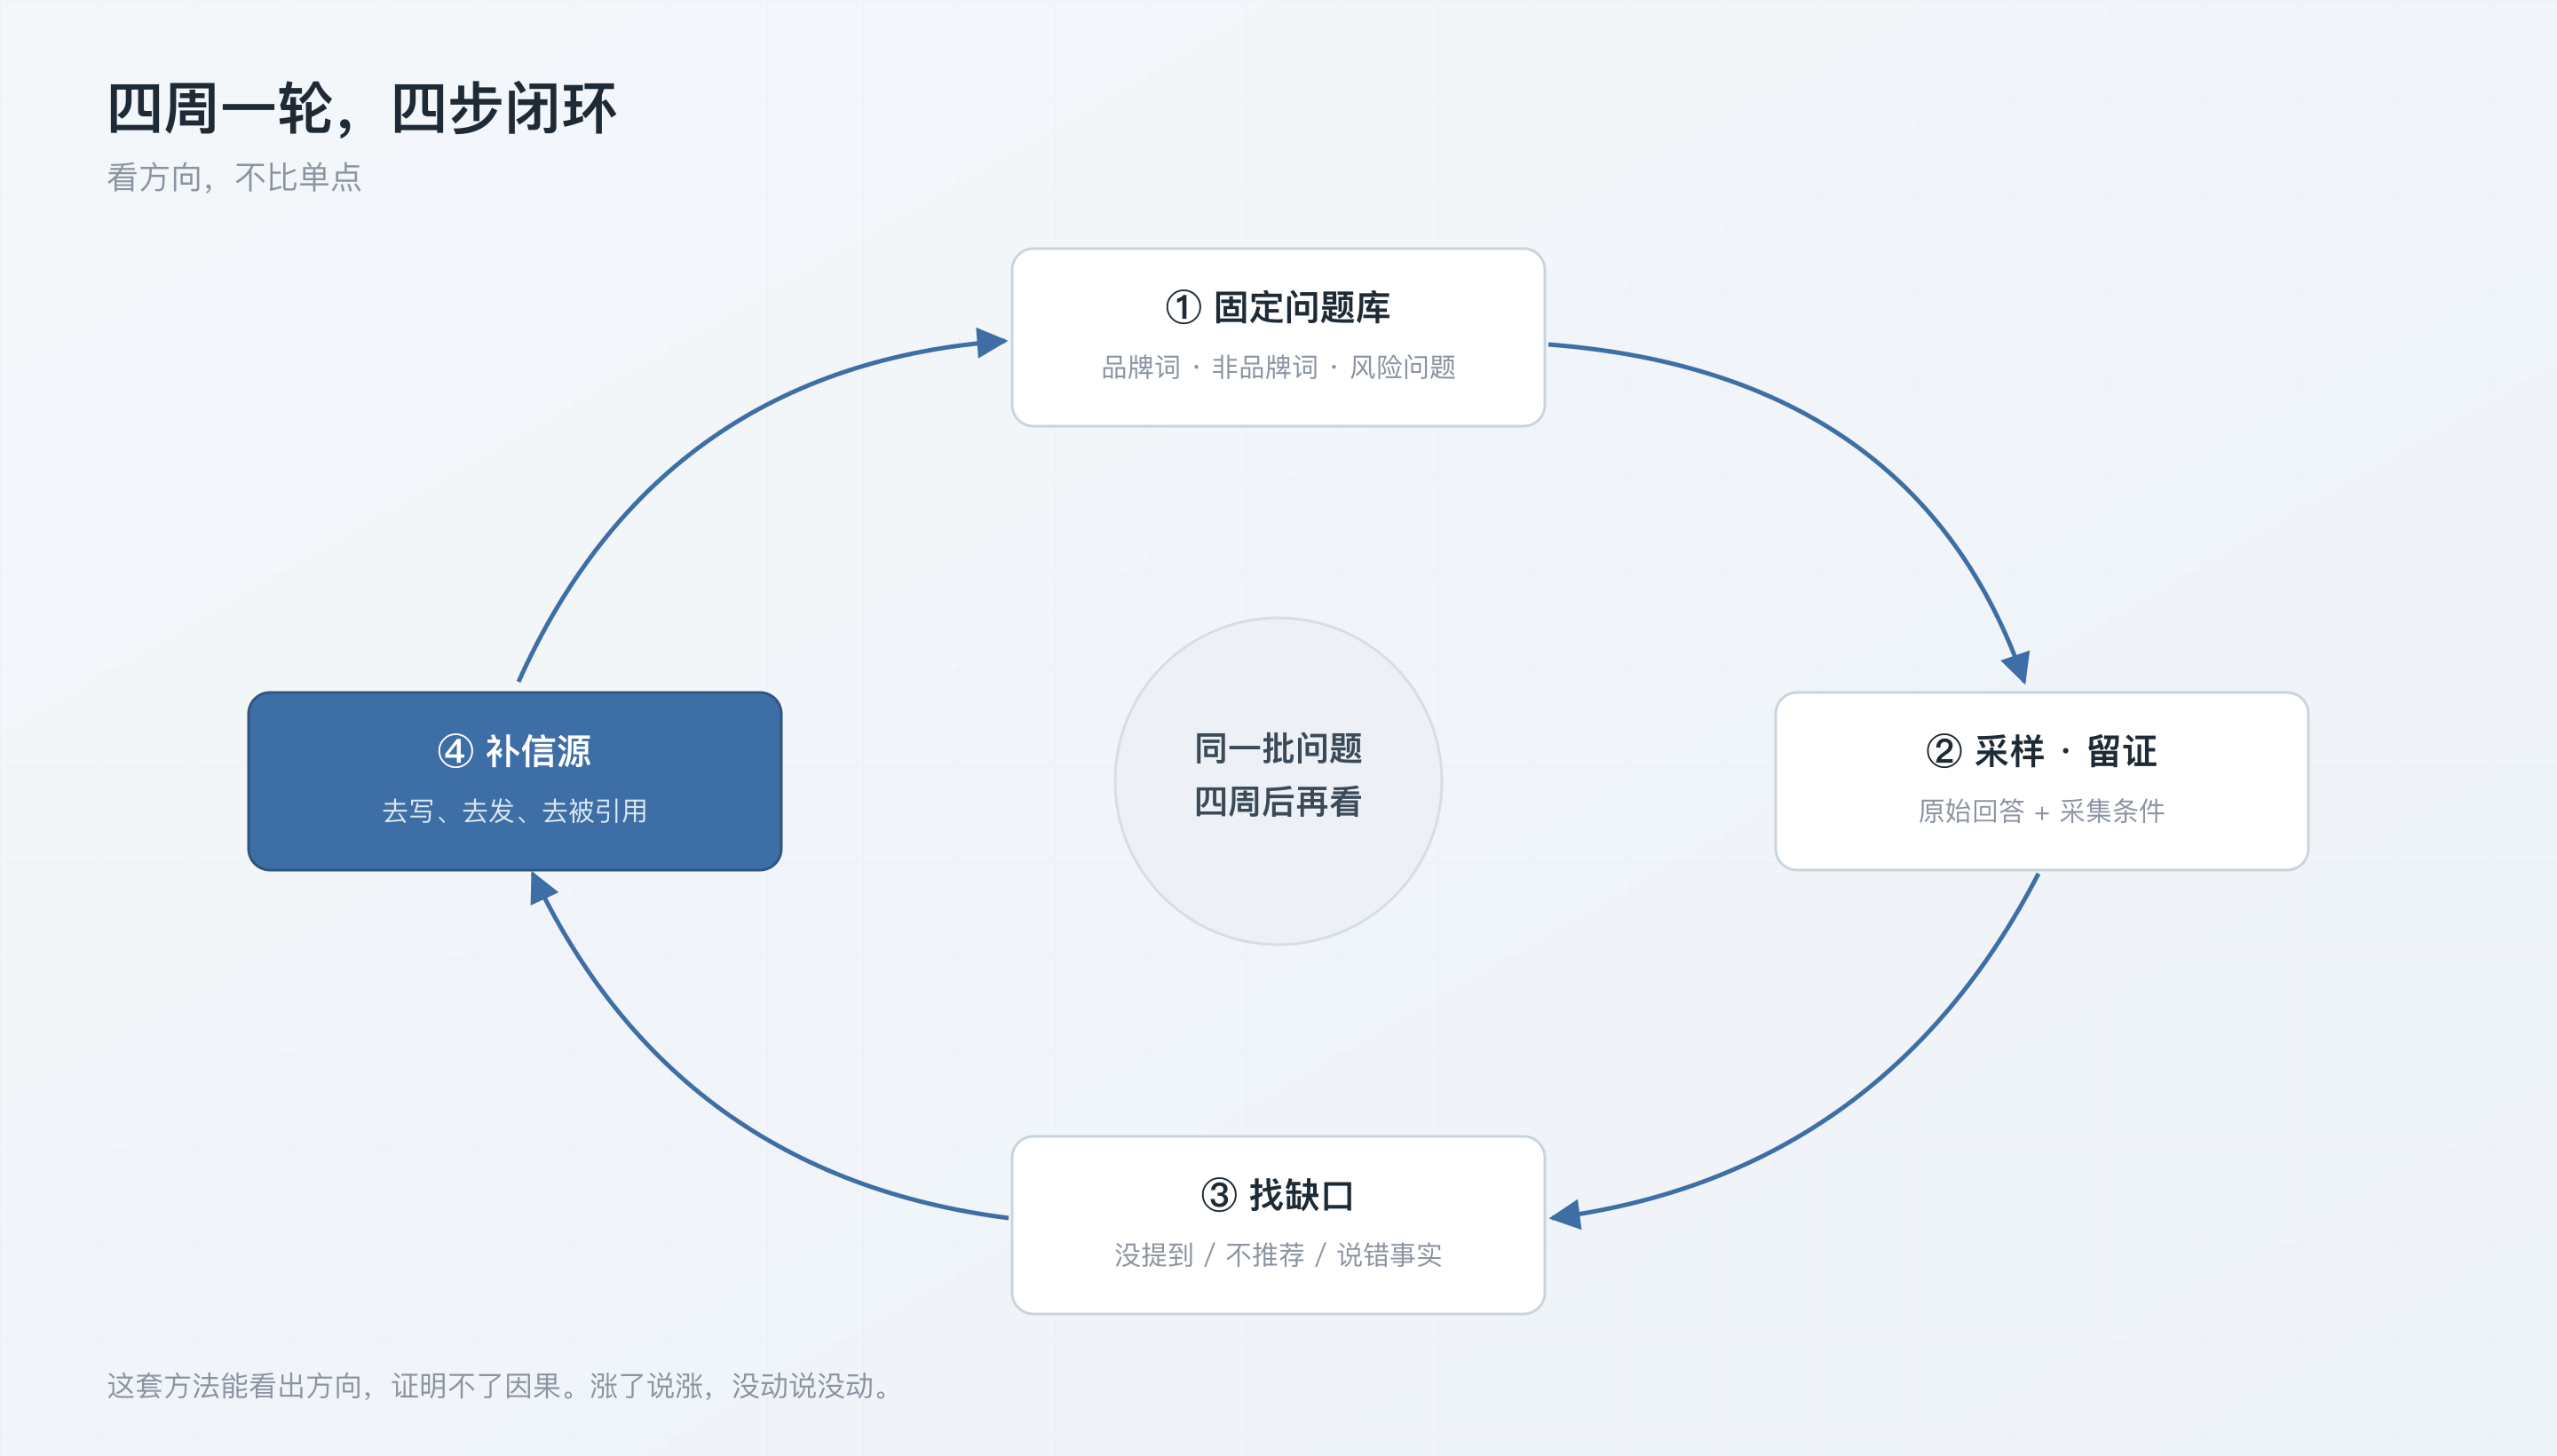
有件事得说清楚:这套方法能看出变化方向,证明不了因果。你补了三篇内容,下个月提及率涨了,也可能只是平台换了模型。样本量和平台差异摆在那儿,说“因为我做了 X 所以涨了 Y”,不诚实。
最后
回到开头那个问题:看完一份报告,我该做什么。
答案不在报告里。报告能做的,是把“你在哪些问题上不存在”这件事摆到桌面上。
知道病在哪,接下来是怎么用药。我的方子就三味:官网是证据仓,平台是引用入口,一手证据是弹药。 三件事的顺序不能反——先把能被验证的东西放稳,再谈被谁看到。
下一篇我会把这三味药拆开讲清楚:自己家的 GEO 怎么一步步做上去,官网那几项动完就不用再管,平台发文按什么标准挑,一手证据从哪儿来。
GeoLens 我还在用,也还在改。它解决的是“我看不见”的问题,解决不了“我不值得被推荐”的问题。这两件事经常被混为一谈,包括我自己刚做这个产品的时候。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!